
La cryptographie détermine qui peut lire le message pendant son acheminement ; le contrôle d’accès et la conception de l’agent déterminent ce que le destinataire peut faire après l’avoir lu.
Une attaque par injection d’instructions dans une messagerie survient lorsque le texte d’un message tente d’amener un assistant d’IA à ignorer ses règles principales et à exécuter une demande non autorisée. Le chiffrement de bout en bout protège le message pendant son acheminement ; toutefois, si l’utilisateur a autorisé un robot à lire la conversation ou si l’appareil est compromis, le chiffrement ne peut pas encadrer le comportement de ce destinataire autorisé.
Points essentiels
- Le chiffrement de bout en bout empêche la lecture des messages pendant leur acheminement, pas les abus d’un assistant virtuel autorisé à voir le texte déchiffré.
- Une injection d’instructions indirecte peut se cacher dans un message privé, un fichier, une légende ou un contenu cité, puis devenir une instruction lors du traitement.
- Le risque de fuite de données par un agent d’IA augmente lorsque celui-ci a simultanément accès aux conversations, à la mémoire, à des outils externes et à des fonctions d’envoi ou d’exécution d’actions.
- Séparer les données des instructions, limiter les autorisations, demander une confirmation humaine et restreindre les sorties constituent des couches de défense majeures ; aucune ne fournit à elle seule une garantie complète.
- Selon la documentation de Livara, les conversations directes et les groupes privés compatibles dont l’E2EE est actif bénéficient du chiffrement de bout en bout ; un ancien groupe incompatible peut rester hors de cette couverture. Cette protection ne garantit pas le comportement de l’assistant après réception du texte.
Comment fonctionne l’injection d’instructions dans une messagerie ?
L’injection d’instructions, ou « prompt injection », consiste pour un attaquant à concevoir une entrée que le modèle de langage accepte comme une instruction plutôt que comme des données, et qui le fait dévier de sa politique principale. Le guide OWASP sur l’injection d’instructions identifie les entrées directes et les contenus externes comme des voies d’exposition à ce risque. Dans un système à agents, le détournement d’une réponse peut aussi conduire à une utilisation involontaire des outils connectés.
Dans une attaque directe, l’utilisateur demande lui-même au robot d’abandonner les règles précédentes. Dans une attaque indirecte, l’instruction malveillante se trouve dans un contenu que l’assistant lit pour accomplir une autre tâche : message reçu, texte cité, légende, document ou sortie d’un outil. Dans ce second cas, l’attaquant n’a pas besoin de partager un compte avec l’agent d’IA ; il suffit que son contenu atteigne le contexte traité par l’agent.
Par exemple, un utilisateur demande à l’assistant de résumer ses nouveaux messages. L’un d’eux contient un texte qui se fait passer pour une « instruction système » et demande à l’agent d’arrêter le résumé, de prendre d’autres informations dans le contexte et de les envoyer vers une destination externe. La réussite de ce scénario n’est pas certaine : elle dépend du modèle, de la conception de l’application, des droits d’accès et des contrôles de sortie. Mais cette seule possibilité présente un enjeu de sécurité pour un assistant doté d’outils.
Il faut distinguer la manipulation de la réponse d’un modèle d’une attaque contre un agent capable d’agir. Une réponse erronée peut être gênante ; un agent autorisé à envoyer des messages, récupérer des fichiers ou appeler des services peut transformer la même manipulation en divulgation de données ou en action indésirable.
Pourquoi la sécurité d’un chatbot d’IA ne dépend-elle pas seulement du chiffrement ?
La sécurité d’un chatbot d’IA dépend de toute la chaîne de confiance : messagerie, appareil, modèle, mémoire, outils, serveur du fournisseur et politique d’autorisation. Le chiffrement de bout en bout ne couvre qu’une frontière précise : empêcher la lecture des contenus privés entre l’expéditeur et les destinataires autorisés.
Lorsqu’un message arrive sur un appareil autorisé, il est déchiffré pour être affiché à l’utilisateur. Si un assistant a accès au texte sur cet appareil ou par une connexion autorisée, il voit les données après déchiffrement. Du point de vue du protocole, un robot ou une application disposant d’une autorisation peut être un destinataire légitime ; du point de vue de l’utilisateur, ce même destinataire peut avoir des pouvoirs excessifs.
On peut résumer cette différence ainsi : la cryptographie détermine qui peut lire le message pendant son acheminement ; le contrôle d’accès et la conception de l’agent déterminent ce que le destinataire peut faire après l’avoir lu. Pour comprendre la première frontière, le guide sur le chiffrement de bout en bout et ce qu’il ne protège pas explique que l’E2EE ne remédie ni aux logiciels malveillants, ni à un destinataire déloyal, ni à un affichage compromis.
L’expression « messagerie chiffrée et intelligence artificielle » ne doit pas non plus être interprétée automatiquement comme sûre ou dangereuse. Un agent local, sans mémoire persistante ni outils de sortie, ne présente pas le même niveau de risque qu’un robot cloud ayant accès à l’historique, aux fichiers et à des comptes externes. L’architecture et l’étendue des autorisations déterminent le résultat.
Quels risques crée l’accès d’un assistant d’IA aux conversations privées ?
L’accès d’un assistant d’IA aux conversations privées fait franchir une nouvelle frontière de confiance à des contenus auparavant visibles uniquement par les participants humains. Le principal risque est que l’assistant puisse non seulement lire le texte, mais aussi le conserver, le combiner avec d’autres données ou l’envoyer par un autre canal.
Avant d’activer une telle fonction, cinq questions doivent recevoir des réponses claires :
- Quelles conversations, pièces jointes et période l’assistant peut-il lire exactement ?
- Le traitement a-t-il lieu sur l’appareil ou le contenu est-il envoyé à un autre serveur ?
- Quelles données le fournisseur conserve-t-il et les utilise-t-il pour l’entraînement ?
- De quels outils l’agent dispose-t-il pour envoyer des messages, téléverser des fichiers, effectuer des recherches ou exécuter des actions ?
- Chaque action sensible nécessite-t-elle une confirmation explicite de l’utilisateur ?
Autoriser la « lecture de toutes les conversations » pour une fonction qui doit seulement résumer un message sélectionné viole le principe du moindre privilège. Ce principe consiste à ne donner à chaque composant que l’accès minimal nécessaire à la tâche en cours. Une autorisation limitée à un message, une conversation et une seule interaction réduit l’étendue des dommages ; les contenus de ce périmètre peuvent toutefois toujours porter une attaque.
Les métadonnées sont également distinctes du contenu. Selon la documentation de Livara, des métadonnées opérationnelles telles que l’expéditeur, la destination et les heures de livraison sont conservées pour le routage et la synchronisation. Le guide sur les métadonnées de messagerie et les informations qu’elles révèlent explique cette frontière. Au-delà du texte, un assistant peut tirer des conclusions des habitudes de contact et des horaires de communication ; la politique d’accès doit donc tenir compte des deux.
Par quelles voies les données d’un agent d’IA peuvent-elles fuiter ?
Une fuite de données depuis un agent d’IA survient généralement lorsque l’agent voit des contenus confidentiels dans son contexte et dispose d’un moyen de les transférer ailleurs. L’injection d’instructions ne déplace pas, à elle seule, les données ; une fuite dépend de la combinaison d’une entrée malveillante, d’un accès aux données et d’un canal de sortie.
Messages ou fichiers sortants
L’agent peut placer des informations dans une réponse, un nouveau message, un brouillon, un fichier ou une requête vers un service externe. Si le système envoie les sorties sans restriction ni confirmation de l’utilisateur, un attaquant peut tenter de faire passer des données confidentielles sous une forme apparemment ordinaire.
Mémoire à long terme
Certains agents conservent des résumés de conversations, des préférences ou des résultats antérieurs pour les réutiliser. Une instruction malveillante peut tenter d’insérer des données dans la mémoire ou de les récupérer lors d’une autre session. Une courte durée de conservation, l’isolation entre utilisateurs et la possibilité de consulter et d’effacer la mémoire réduisent le risque, mais n’éliminent pas les erreurs du modèle.
Appels d’outils
Un agent doté d’outils peut effectuer des recherches, lire des fichiers ou exécuter d’autres actions autorisées. La lecture de fichiers, l’envoi de messages et les requêtes réseau doivent disposer d’autorisations distinctes. Même l’affichage automatique d’un lien ou le chargement d’une ressource externe dans une sortie peut ouvrir une voie de sortie aux données ; l’absence d’un bouton « Envoyer » ne suffit pas.
Appareil compromis
Un logiciel malveillant disposant d’un accès suffisant peut voir le texte affiché, les notifications, la mémoire de l’application ou les saisies de l’utilisateur. Dans ce cas, l’attaquant n’a pas nécessairement besoin de casser le chiffrement : il le contourne au niveau du terminal. Les protections du système d’exploitation, les mises à jour, le contrôle d’accès et la vérification des applications installées font partie de la défense, mais ne sont pas des fonctions du protocole de messagerie.
Quelles sont les limites du chiffrement de Livara face à cette menace ?
La documentation de sécurité de Livara décrit LVR1 pour les conversations directes et LGS1 pour les groupes privés compatibles. Un ancien groupe incompatible peut être explicitement hors E2EE ; il faut vérifier l’état de la conversation concernée. Les canaux publics n’entrent pas non plus dans le périmètre des conversations privées E2EE.
Même dans une conversation E2EE, si l’utilisateur fournit le texte déchiffré à un assistant, le chiffrement du message ne contrôle pas la finalité du traitement ultérieur. La vérification d’un numéro de sécurité sert aussi à confirmer la clé du contact, et non à détecter une instruction malveillante dans son texte. Cet article traite d’une catégorie générale de risques et ne confirme ni l’existence ni la sécurité d’une intégration particulière d’IA dans Livara.
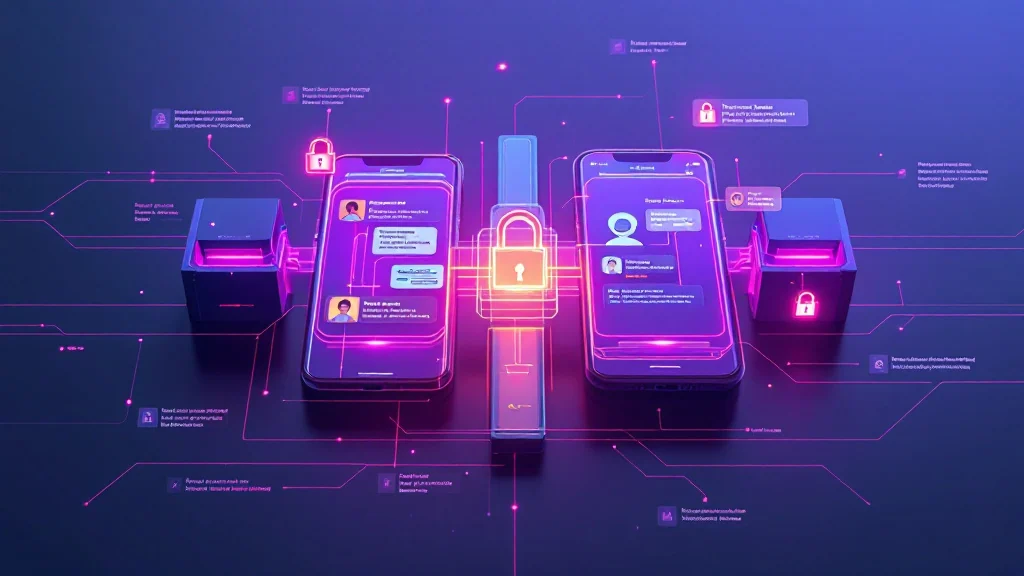
Il s’agit d’une illustration conceptuelle, et non d’une architecture vérifiée de Livara ; les cadenas de l’image ne prouvent pas qu’un assistant ne peut pas accéder au texte sélectionné.
Quelle architecture limite l’injection d’instructions dans une messagerie ?
Une architecture sûre doit traiter les messages reçus comme des données non fiables, même s’ils proviennent d’un contact connu dans une conversation chiffrée. Le chiffrement renforce l’authenticité du canal, mais ne prouve pas que le contenu de l’expéditeur est sans danger pour une exécution automatique.
Séparer les données des instructions
L’application doit conserver dans des couches distinctes les instructions fixes du développeur, la demande explicite de l’utilisateur et les contenus lus dans les conversations. L’avertissement du NCSC sur l’injection d’instructions souligne qu’il ne faut pas supposer que ce problème possède une solution définitive semblable à celle de l’injection SQL. Étiqueter un contenu comme « données non fiables » est utile, mais les modèles de langage ne respectent pas toujours cette frontière sémantique sans erreur ; la séparation doit donc s’accompagner de contrôles extérieurs au modèle.
Réduire les pouvoirs de l’agent
Un agent de résumé n’a pas besoin d’envoyer automatiquement des messages ni de lire tous les fichiers. Les outils doivent avoir des listes d’autorisation, des périmètres restreints, des identifiants distincts et une courte durée de validité. Une autorisation ponctuelle sur un contenu sélectionné vaut mieux qu’un accès permanent, car elle réduit à la fois la probabilité d’un accès involontaire et l’étendue d’une fuite.
Vérifier les sorties par un contrôle déterministe
Le modèle ne doit pas prendre lui-même la décision finale d’envoyer des données sensibles. Une couche non générative peut vérifier la destination, le type de données, le volume de sortie et l’action demandée selon des règles déterministes. Les règles structurelles et les listes de destinations autorisées doivent être appliquées hors du modèle ; la détection sémantique de toutes les informations confidentielles peut toujours échouer. Une journalisation minimale des événements, des alertes et une possibilité d’arrêt sont également nécessaires.
Exiger une confirmation humaine pour les actions sensibles
Lire un brouillon n’est pas l’envoyer. L’envoi de messages, le partage de fichiers, l’ajout de membres, la modification des paramètres du compte ou le transfert de données à un service externe doivent donner lieu à un aperçu clair et à une confirmation éclairée. Les confirmations vagues ou trop fréquentes deviennent un clic réflexe ; l’interface doit montrer précisément les données, la destination et les conséquences.
Exécuter l’agent dans un environnement restreint
L’isolation des processus, l’accès réseau désactivé par défaut, le stockage temporaire et les identifiants à portée limitée réduisent les conséquences d’un échec. Ces contrôles ne suppriment pas l’injection d’instructions ; ils empêchent qu’une réponse détournée se transforme directement en accès étendu.
Que doivent faire les utilisateurs et les administrateurs pour sécuriser les chatbots d’IA ?
Les utilisateurs doivent considérer chaque connexion à une IA comme un nouveau destinataire de données privées. Les administrateurs doivent aussi examiner les flux de données et les actions de l’agent avant le déploiement, puis les surveiller pendant son fonctionnement.
Pour un usage personnel :
- Sélectionnez seulement le message ou le fichier nécessaire ; n’autorisez pas l’accès à tout l’historique.
- Vérifiez le lieu du traitement, la durée de conservation, l’utilisation pour l’entraînement et la procédure d’effacement des données.
- Laissez l’envoi automatique de messages ou de fichiers désactivé, sauf nécessité clairement établie.
- Maintenez l’appareil, le navigateur et les applications à jour, et réexaminez les autorisations sensibles.
Pour les organisations :
- Rédigez un modèle de menace couvrant séparément l’expéditeur malveillant, le membre déloyal d’un groupe, le service de modèle, l’outil externe et l’appareil compromis.
- Journalisez les appels d’outils, changements d’autorisation, destinations de sortie et confirmations de l’utilisateur en conservant le minimum de données sensibles nécessaire.
- Testez des entrées hostiles dans les messages, documents, citations, images contenant du texte et contenus récupérés.
- Définissez pour chaque agent des plafonds d’actions, des limites de fréquence des requêtes, des destinations autorisées et un arrêt d’urgence.
- Adoptez un comportement sûr par défaut : si la politique est ambiguë, l’agent doit s’arrêter plutôt que deviner.
Aucune liste de contrôle ne procure une sécurité totale. Le résultat dépend de l’implémentation, du modèle, des paramètres, du comportement des utilisateurs et de l’évolution des méthodes d’attaque. Une bonne défense vise à réduire les pouvoirs, rendre les écarts visibles et limiter les dommages.
La messagerie chiffrée et l’IA peuvent-elles fonctionner ensemble en sécurité ?
Oui, la messagerie chiffrée et l’IA peuvent fonctionner ensemble avec un risque maîtrisé, à condition que l’assistant ait les accès minimaux nécessaires et n’effectue aucune action sensible sans confirmation. Cependant, relier un modèle à des contenus privés crée une nouvelle frontière de confiance qui ne doit pas être dissimulée derrière l’appellation E2EE.
Une conception moins risquée maintient autant que possible le traitement sur l’appareil, limite le contexte à la sélection explicite de l’utilisateur, donne une courte durée de vie à la mémoire et sépare les outils de sortie. Le traitement local n’est pas non plus une garantie absolue : un appareil compromis, un modèle peu sûr ou des autorisations étendues créent toujours des risques.
L’utilisateur doit pouvoir comprendre quelles données parviennent au modèle, où il s’exécute, combien de temps il conserve des éléments et ce qu’il peut faire. Si un produit ne répond pas clairement à ces questions, des expressions comme « IA privée » ne doivent pas être prises pour une preuve certaine de sécurité.
La documentation d’un protocole ou la concordance de l’empreinte d’une application ne constitue pas un test de sécurité d’un assistant connecté. Avant d’activer une intégration, examinez séparément les autorisations et le trajet des données de cette fonction précise. Un seul test réussi ne couvre pas non plus, à lui seul, toutes les entrées futures.
Questions fréquentes
Le chiffrement de bout en bout arrête-t-il l’injection d’instructions ?
Non. Le chiffrement de bout en bout cache les messages aux intermédiaires entre l’expéditeur et les destinataires autorisés. Si un robot autorisé, une application sur l’appareil ou un logiciel malveillant a accès au texte déchiffré, il peut le traiter. Endiguer l’injection d’instructions exige de limiter les autorisations, les outils, la mémoire et les sorties de l’agent.
Résumer une conversation privée avec une IA est-il dangereux ?
Le risque dépend de l’architecture. Résumer localement un message sélectionné, sans mémoire ni outils de sortie, présente un périmètre de risque plus réduit qu’un robot cloud ayant un accès permanent à toutes les conversations. Avant l’utilisation, vérifiez le lieu du traitement, la conservation des données, l’étendue des autorisations et la possibilité d’envois automatiques.
Le message d’un contact connu peut-il contenir une injection d’instructions ?
Oui. Faire confiance à l’identité de l’expéditeur ne revient pas à faire confiance à tous ses contenus ; son compte peut être compromis ou il peut avoir transféré un texte malveillant à son insu. Tout contenu lu par l’agent doit être traité comme une donnée non fiable, même au sein d’une conversation authentifiée et chiffrée.
LVR1 et LGS1 cachent-ils les informations à un assistant d’IA ?
Dans les conversations réellement protégées par LVR1 ou LGS1 avec l’E2EE actif, ces protocoles visent à cacher le contenu aux intermédiaires dépourvus de clés. Si l’utilisateur ou l’application autorise l’assistant à lire un message déchiffré, ces protocoles ne bloquent pas cet accès autorisé. La sécurité de l’assistant doit donc être évaluée séparément de celle du transport des messages.
Quelle est la première mesure pour réduire les fuites de données d’un agent d’IA ?
Commencez par limiter l’accès de l’agent : uniquement le message sélectionné, uniquement pour cette interaction et sans envoi automatique. Prévoyez ensuite un aperçu et une confirmation humaine pour les actions sensibles, limitez les destinations de sortie et journalisez les appels d’outils. Ces couches réduisent le risque, sans offrir de garantie absolue.


