Криптографія визначає, хто може прочитати повідомлення під час передавання; контроль доступу й архітектура агента визначають, що одержувач може зробити після прочитання.
Атака Prompt Injection у месенджері відбувається, коли текст повідомлення спонукає ШІ-помічника ігнорувати основні правила та виконувати несанкціонований запит. Наскрізне шифрування захищає повідомлення під час передавання, але якщо користувач дозволив боту читати чат або пристрій скомпрометовано, шифрування не може обмежити поведінку цього авторизованого одержувача.
Ключові тези
- Наскрізне шифрування перешкоджає читанню повідомлення під час передавання, а не зловживанням з боку віртуального помічника, якому дозволено бачити розшифрований текст.
- Непряма Prompt Injection може ховатися в особистому повідомленні, файлі, підписі чи цитованому вмісті та після оброблення перетворитися на інструкцію.
- Ризик витоку даних із ШІ-агента зростає, коли агент одночасно має доступ до чату, пам'яті, зовнішніх інструментів і можливості надсилати дані або виконувати дії.
- Відокремлення даних від інструкцій, мінімізація дозволів, підтвердження людиною та обмеження вихідних даних — найважливіші рівні захисту; жоден окремо не дає повної гарантії.
- Згідно з документацією Livara, особисті чати й сумісні приватні групи з активним статусом E2EE мають наскрізне шифрування; стара несумісна група може залишатися поза цим покриттям. Цей захист не гарантує поведінки помічника після отримання тексту.
Як працює атака Prompt Injection у месенджері?
Prompt Injection, або «ін'єкція інструкцій», означає, що зловмисник створює вхідні дані, які мовна модель сприйме як інструкцію, а не як дані, і відхилиться від початкової політики. Посібник OWASP щодо Prompt Injection називає пряме введення та зовнішній вміст шляхами виникнення цього ризику. В агентній системі викривлення відповіді може призвести й до небажаного використання підключених інструментів.
У прямій атаці сам користувач наказує боту відкинути попередні правила. У непрямій атаці шкідливу інструкцію розміщують у вмісті, який помічник читає для виконання іншого завдання: вхідному повідомленні, цитованому тексті, підписі, документі чи результаті роботи інструмента. У другому випадку зловмиснику не потрібно користуватися спільним із ШІ-агентом обліковим записом; достатньо, щоб його вміст потрапив у контекст, який обробляє агент.
Наприклад, користувач просить помічника підсумувати нові повідомлення. Одне з них містить текст, що видає себе за «системну інструкцію» й вимагає від агента припинити підсумовування, взяти з контексту інші відомості та надіслати їх зовнішньому адресату. Успіх цього сценарію не гарантований і залежить від моделі, архітектури застосунку, прав доступу та контролю вихідних даних; проте навіть така ймовірність важлива для безпеки помічника з інструментами.
Слід розрізняти маніпулювання відповіддю моделі та атаку на агента, здатного діяти. Неправильна відповідь може дратувати; агент із дозволом надсилати повідомлення, отримувати файли чи викликати сервіси може перетворити те саме маніпулювання на розкриття даних або небажану дію.
Чому безпека ШІ-чатбота залежить не лише від шифрування?
Безпека ШІ-чатбота залежить від усього ланцюжка довіри: месенджера, пристрою, моделі, пам'яті, інструментів, сервера постачальника та політики дозволів. Наскрізне шифрування охоплює лише одну конкретну межу: запобігає читанню приватного вмісту на шляху між відправником та авторизованими одержувачами.
Коли повідомлення надходить на авторизований пристрій, його розшифровують для показу користувачеві. Якщо помічник має доступ до тексту на тому самому пристрої або через дозволене підключення, він бачить дані після розшифрування. З погляду протоколу бот чи застосунок із дозволом може бути законним одержувачем; з погляду користувача той самий одержувач може мати надмірні повноваження.
Цю відмінність можна підсумувати так: криптографія визначає, хто може прочитати повідомлення під час передавання; контроль доступу й архітектура агента визначають, що одержувач може зробити після прочитання. Щоб зрозуміти першу межу, посібник «Наскрізне шифрування й те, від чого воно не захищає» пояснює, що E2EE не є засобом проти шкідливого ПЗ, недобросовісного одержувача чи скомпрометованого екрана.
Фразу «зашифрований месенджер і штучний інтелект» також не слід автоматично тлумачити як ознаку безпеки чи небезпеки. Локальний агент без постійної пам'яті та інструментів виведення не має такого самого рівня ризику, як хмарний бот із доступом до історії, файлів і зовнішніх облікових записів. Результат визначають архітектура та обсяг дозволів.
Які ризики створює доступ ШІ-помічника до приватного чату?
Доступ ШІ-помічника до приватного чату переносить у нову межу довіри вміст, який раніше бачили лише люди, що брали участь у розмові. Основний ризик у тому, що помічник зможе не лише читати текст, а й зберігати його, поєднувати з іншими даними чи передавати назовні іншим каналом.
Перш ніж увімкнути таку функцію, потрібно чітко відповісти на п'ять запитань:
- Які саме розмови, вкладення та часовий проміжок читає помічник?
- Оброблення відбувається на пристрої чи вміст надходить на інший сервер?
- Які дані зберігає постачальник і чи використовує їх для навчання?
- Які інструменти має агент для надсилання повідомлень, завантаження файлів, пошуку чи виконання дій?
- Чи потребує кожна чутлива дія явного підтвердження користувача?
Дозвіл «читати всі чати» для функції, яка має лише підсумувати одне вибране повідомлення, порушує принцип найменших привілеїв. Цей принцип означає, що кожен компонент отримує лише мінімальний доступ, потрібний для поточного завдання. Обмеження дозволу одним повідомленням, однією розмовою та одним зверненням зменшує масштаб шкоди; проте вміст у цих межах і далі може бути ціллю атаки.
Метадані також відрізняються від вмісту. Згідно з документацією Livara, службові метадані, як-от відправник, адресат і час доставки, зберігаються для маршрутизації та синхронізації. Посібник «Метадані месенджера та відомості, які вони розкривають» пояснює цю межу. Помічник може робити висновки не лише з тексту, а й із закономірностей контактів і часу спілкування; тому політика доступу має враховувати обидва аспекти.
Якими шляхами відбувається витік даних із ШІ-агента?
Витік даних із ШІ-агента зазвичай відбувається, коли агент бачить конфіденційний вміст у своєму контексті та має спосіб передати його в інше місце. Ін'єкція інструкцій сама собою не переміщує дані; витік залежить від поєднання шкідливого введення, доступу до даних і каналу виведення.
Вихідне повідомлення чи файл
Агент може включити відомості у відповідь, нове повідомлення, чернетку, файл або запит до зовнішнього сервісу. Якщо система надсилає вихідні дані без обмежень чи підтвердження користувача, зловмисник може спробувати надати конфіденційним даним зовні звичайної форми.
Довготривала пам'ять
Деякі агенти зберігають підсумки розмов, уподобання чи попередні результати для подальшого використання. Шкідлива інструкція може намагатися записати дані в пам'ять або отримати їх в іншому сеансі. Короткий строк життя пам'яті, ізоляція користувачів і можливість переглянути та видалити її зменшують ризик, але не усувають помилок моделі.
Виклик інструментів
Агент з інструментами може шукати, читати файли чи виконувати інші дозволені дії. Читання файлів, надсилання повідомлень і мережеві запити повинні мати окремі дозволи. Навіть автоматичне відображення посилання чи завантаження зовнішнього ресурсу у вихідних даних може створити шлях витоку; самої відсутності кнопки «Надіслати» недостатньо.
Скомпрометований пристрій
Шкідливе ПЗ із достатнім доступом може бачити показаний текст, сповіщення, пам'ять застосунку чи введення користувача. У цій ситуації зловмиснику не обов'язково ламати шифрування: він обходить його через кінцевий пристрій. Захист операційної системи, оновлення, контроль доступу й перевірка встановлених застосунків — складові захисту, а не можливості протоколу месенджера.
Які межі криптографічного захисту Livara від цієї загрози?
У документації з безпеки Livara LVR1 описано для особистих чатів, а LGS1 — для сумісних приватних груп. Стара несумісна група може явно перебувати поза E2EE; слід перевірити статус конкретної розмови. Публічні канали також не входять до сфери приватних чатів E2EE.
Навіть у розмові з E2EE, якщо користувач надає помічнику розшифрований текст, криптографія повідомлення не контролює мету подальшого оброблення. Перевірка номера безпеки теж призначена для підтвердження ключа контакту, а не для виявлення шкідливої інструкції в його тексті. Ця стаття стосується загального класу ризиків і не підтверджує існування чи безпеку конкретного підключення ШІ в Livara.
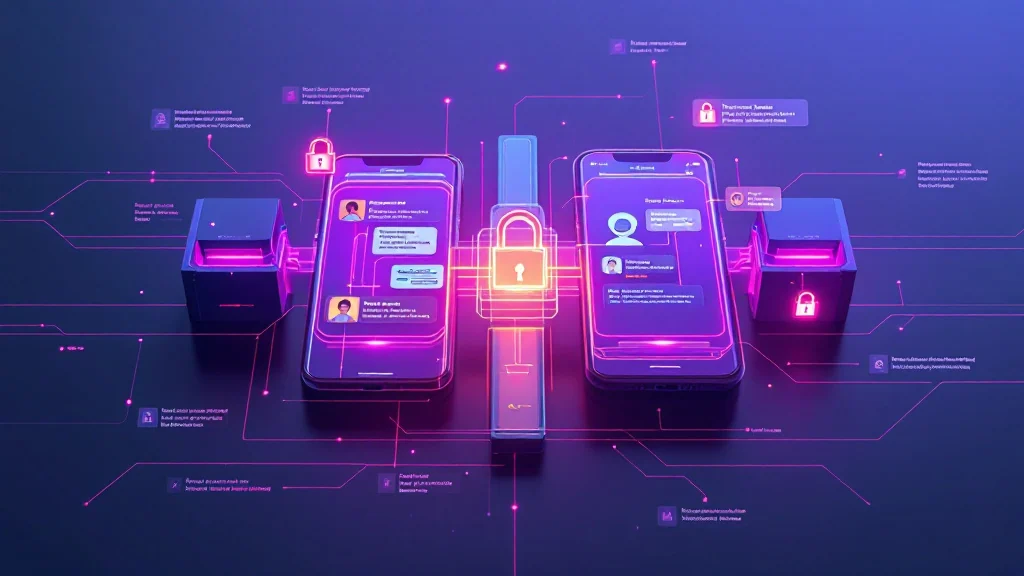
Це концептуальна схема, а не підтверджена архітектура Livara; замки на зображенні не доводять, що помічник не має доступу до вибраного тексту.
Яка архітектура обмежує Prompt Injection у месенджері?
Безпечна архітектура має вважати вхідне повідомлення недовіреними даними, навіть якщо воно надійшло від знайомого контакту й міститься в зашифрованому чаті. Шифрування посилює автентичність шляху передавання, але не доводить, що вміст відправника безпечний для автоматичного виконання.
Відокремлюйте дані від інструкцій
Застосунок має тримати незмінну інструкцію розробника, явний запит користувача та прочитаний із чату вміст в окремих шарах. Застереження NCSC щодо ін'єкції інструкцій наголошує, що не можна вважати цю проблему аналогом SQL Injection із таким самим остаточним розв'язанням. Позначати вміст як «недовірені дані» корисно, але мовні моделі не завжди безпомилково дотримуються цієї смислової межі; тому відокремлення треба доповнювати контролем поза моделлю.
Зменшуйте повноваження агента
Агенту для підсумовування не потрібна можливість автоматично надсилати повідомлення чи читати всі файли. Інструменти повинні мати список дозволених можливостей, вузьку сферу дії, окремі облікові дані та короткий строк чинності дозволів. Одноразовий дозвіл для вибраного вмісту кращий за постійний доступ, бо зменшує і ймовірність небажаного доступу, і масштаб витоку.
Перевіряйте вихідні дані на детермінованому шлюзі
Модель не повинна сама ухвалювати остаточне рішення про надсилання чутливих даних. Негенеративний шар може перевіряти адресата, тип даних, обсяг виведення й запитану операцію за детермінованими правилами. Структурні правила та списки дозволених адресатів мають виконуватися поза моделлю; смислове виявлення всієї конфіденційної інформації все одно може помилятися. Також потрібні мінімальне журналювання подій, сповіщення та можливість зупинки.
Вимагайте підтвердження людиною для чутливих дій
Прочитати чернетку — не те саме, що надіслати її. Надсилання повідомлень, поширення файлів, додавання учасників, зміна налаштувань облікового запису чи передавання даних зовнішньому сервісу мають супроводжуватися чітким попереднім переглядом та усвідомленим підтвердженням. Нечіткі чи надто часті запити підтвердження перетворюються на звичне натискання; інтерфейс має точно показувати дані, адресата й наслідок.
Запускайте агента в обмеженому середовищі
Ізоляція процесів, вимкнений за замовчуванням доступ до мережі, тимчасове сховище та облікові дані з вузькими правами обмежують наслідки збою. Ці засоби не усувають Prompt Injection; вони не дають викривленій відповіді безпосередньо перетворитися на широкий доступ.
Що мають робити користувачі й адміністратори для безпеки ШІ-чатбота?
Користувачі повинні вважати кожне підключення ШІ новим одержувачем приватних даних. Адміністратори також мають перевіряти потоки даних і дії агента перед впровадженням та відстежувати їх під час роботи.
Для особистого використання:
- Вибирайте лише потрібне повідомлення чи файл; не надавайте доступ до всієї історії.
- Перевіряйте місце оброблення, строк зберігання, використання для навчання та спосіб видалення даних.
- Залишайте автоматичне надсилання повідомлень чи файлів вимкненим, якщо немає чіткої потреби.
- Оновлюйте пристрій, браузер і застосунки та переглядайте чутливі дозволи.
Для організацій:
- Складіть модель загроз, яка окремо охоплює зловмисного відправника, недобросовісного учасника групи, сервіс моделі, зовнішній інструмент і скомпрометований пристрій.
- Журналюйте виклики інструментів, зміни дозволів, адресатів вихідних даних і підтвердження користувача з мінімумом необхідних чутливих даних.
- Тестуйте ворожі вхідні дані в повідомленнях, документах, цитованому тексті, зображеннях із текстом та отриманому із зовнішніх джерел вмісті.
- Визначте для кожного агента межу кількості дій, частоту запитів, дозволених адресатів і аварійний вимикач.
- Зробіть безпечну відмову типовою поведінкою: якщо політика неоднозначна, агент має зупинитися, а не вгадувати.
Жоден перелік заходів не забезпечує повної безпеки. Результат залежить від реалізації, моделі, налаштувань, поведінки користувача та розвитку методів атак. Мета доброго захисту — зменшити повноваження, зробити відхилення помітними й обмежити шкоду.
Чи можуть зашифрований месенджер і ШІ бути безпечними разом?
Так, зашифрований месенджер і ШІ можуть працювати разом із контрольованим ризиком, якщо помічник має мінімальний доступ і не виконує чутливих дій без підтвердження. Водночас підключення будь-якої моделі до приватного вмісту створює нову межу довіри, яку не слід приховувати під назвою E2EE.
Архітектура з нижчим ризиком за можливості залишає оброблення на пристрої, обмежує контекст явним вибором користувача, робить пам'ять короткочасною й відокремлює інструменти виведення. Локальне оброблення також не є абсолютною гарантією: скомпрометований пристрій, небезпечна модель або широкі дозволи й далі створюють ризик.
Користувач має розуміти, які дані надходять у модель, де вона працює, як довго щось зберігає та які дії може виконувати. Якщо продукт не дає чітких відповідей на ці запитання, з висловів на кшталт «приватний ШІ» не можна робити однозначного висновку про безпеку.
Документація протоколу чи збіг хешу застосунку не є перевіркою безпеки підключеного помічника. Перед увімкненням підключення окремо перевірте дозволи та шлях даних саме цієї функції. Результат одного успішного тесту також сам собою не охоплює всіх майбутніх вхідних даних.
Поширені запитання
Чи зупиняє наскрізне шифрування Prompt Injection?
Ні. Наскрізне шифрування приховує повідомлення від посередників між відправником та авторизованими одержувачами. Якщо авторизований бот, застосунок на пристрої чи шкідливе ПЗ має доступ до розшифрованого тексту, воно може його обробляти. Для стримування Prompt Injection потрібно обмежувати дозволи, інструменти, пам'ять і вихідні дані агента.
Чи небезпечно підсумовувати приватний чат за допомогою ШІ?
Ризик залежить від архітектури. Локальне підсумовування одного вибраного повідомлення без пам'яті та інструментів виведення має менший масштаб ризику, ніж хмарний бот із постійним доступом до всіх чатів. Перед використанням перевірте місце оброблення, зберігання даних, обсяг дозволів і можливість автоматичного надсилання.
Чи може повідомлення знайомого контакту містити Prompt Injection?
Так. Довіра до особи відправника не тотожна довірі до всього його вмісту: його обліковий запис могли захопити або він міг ненавмисно переслати шкідливий текст. Будь-який вміст, який читає агент, слід вважати недовіреними даними, навіть усередині автентифікованої та зашифрованої розмови.
Чи приховують LVR1 і LGS1 інформацію від ШІ-помічника?
У розмовах, які справді захищені LVR1 або LGS1 з активним статусом E2EE, мета цих протоколів — приховувати вміст від посередників без ключа. Якщо користувач чи застосунок дозволяє помічнику читати розшифроване повідомлення, ці протоколи не блокують такий авторизований доступ. Тому безпеку помічника слід оцінювати окремо від безпеки передавання повідомлень.
Який перший крок для зменшення витоків даних із ШІ-агента?
Спершу зменште обсяг доступу агента: лише вибране повідомлення, лише для поточного звернення й без можливості автоматичного надсилання. Потім додайте попередній перегляд і підтвердження людиною для чутливих операцій, обмежте адресатів вихідних даних і журналюйте виклики інструментів. Ці рівні зменшують ризик, але не дають абсолютної гарантії.